Tibo又放話要RESET了,大夥是不是又要UltraFast開起來了?
知道快要 Reset 了,平常卻沒準備任務,就容易在重置前臨時亂燒。我寧願備好幾件能各自完成的工作,用 medium、必要時 high 併行推進。
我加入的一些 AI 群組裡,只要 Tibo 預告要 Reset,就會有人曬出 Astra、Ultra、fast 全開的截圖。
我的第一反應其實是會直接笑出來。
Tibo 本名 Thibault Sottiaux,是 OpenAI 的 Codex 負責人,也負責公司的產品與平台。
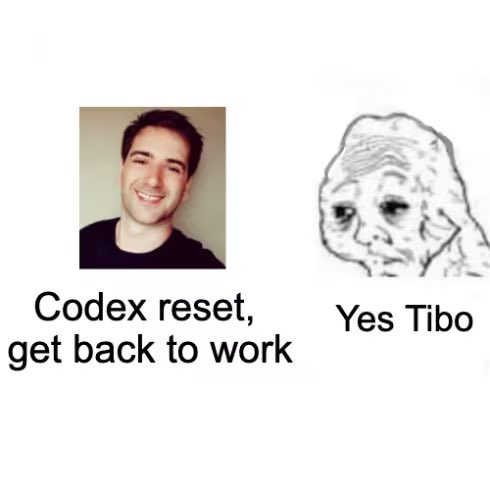
「額度重置了,回去工作吧。」「好的,Tibo。」梗圖原圖

除了梗圖,還有網友做了 Codex Resets,專門追他的 Reset 消息。
額度又要補滿了,當然開心。但每次聽到這個消息,我也會想到自己的麻煩:平常如果沒準備好任務,眼看就快重置,一時還真不知道該拿來做什麼。
臨時硬找個題目,再把推理強度拉滿,做完卻不知道要拿來幹嘛,很容易就白白亂燒了。
大部分範圍已經清楚的任務,其實根本用不到這麼高的推理強度。Extra High、Max 在我心裡比較像鑽頭或手術刀:碰到一個難以攻克的點,需要仔細處理;或是做為決定性承重事實,錯的代價會很大的時候,才會拿出來用。
把推理強度往上拉,結果就一定會更好嗎?
在 Inverse Scaling in Test-Time Compute 裡,有一項測試是根據讀書時間、睡眠、壓力等資料,預測學生的成績。研究者發現,o3-mini 提高推理強度後,預測反而更不準。另一篇 Does Thinking More Always Help? 則讓 DeepSeek-R1 的蒸餾模型(用大型模型的回答訓練出來的小型模型)做數學題,從小學應用題到競賽題都有;在模型準備結束思考時,反覆要求它繼續想,答對率先升後降。
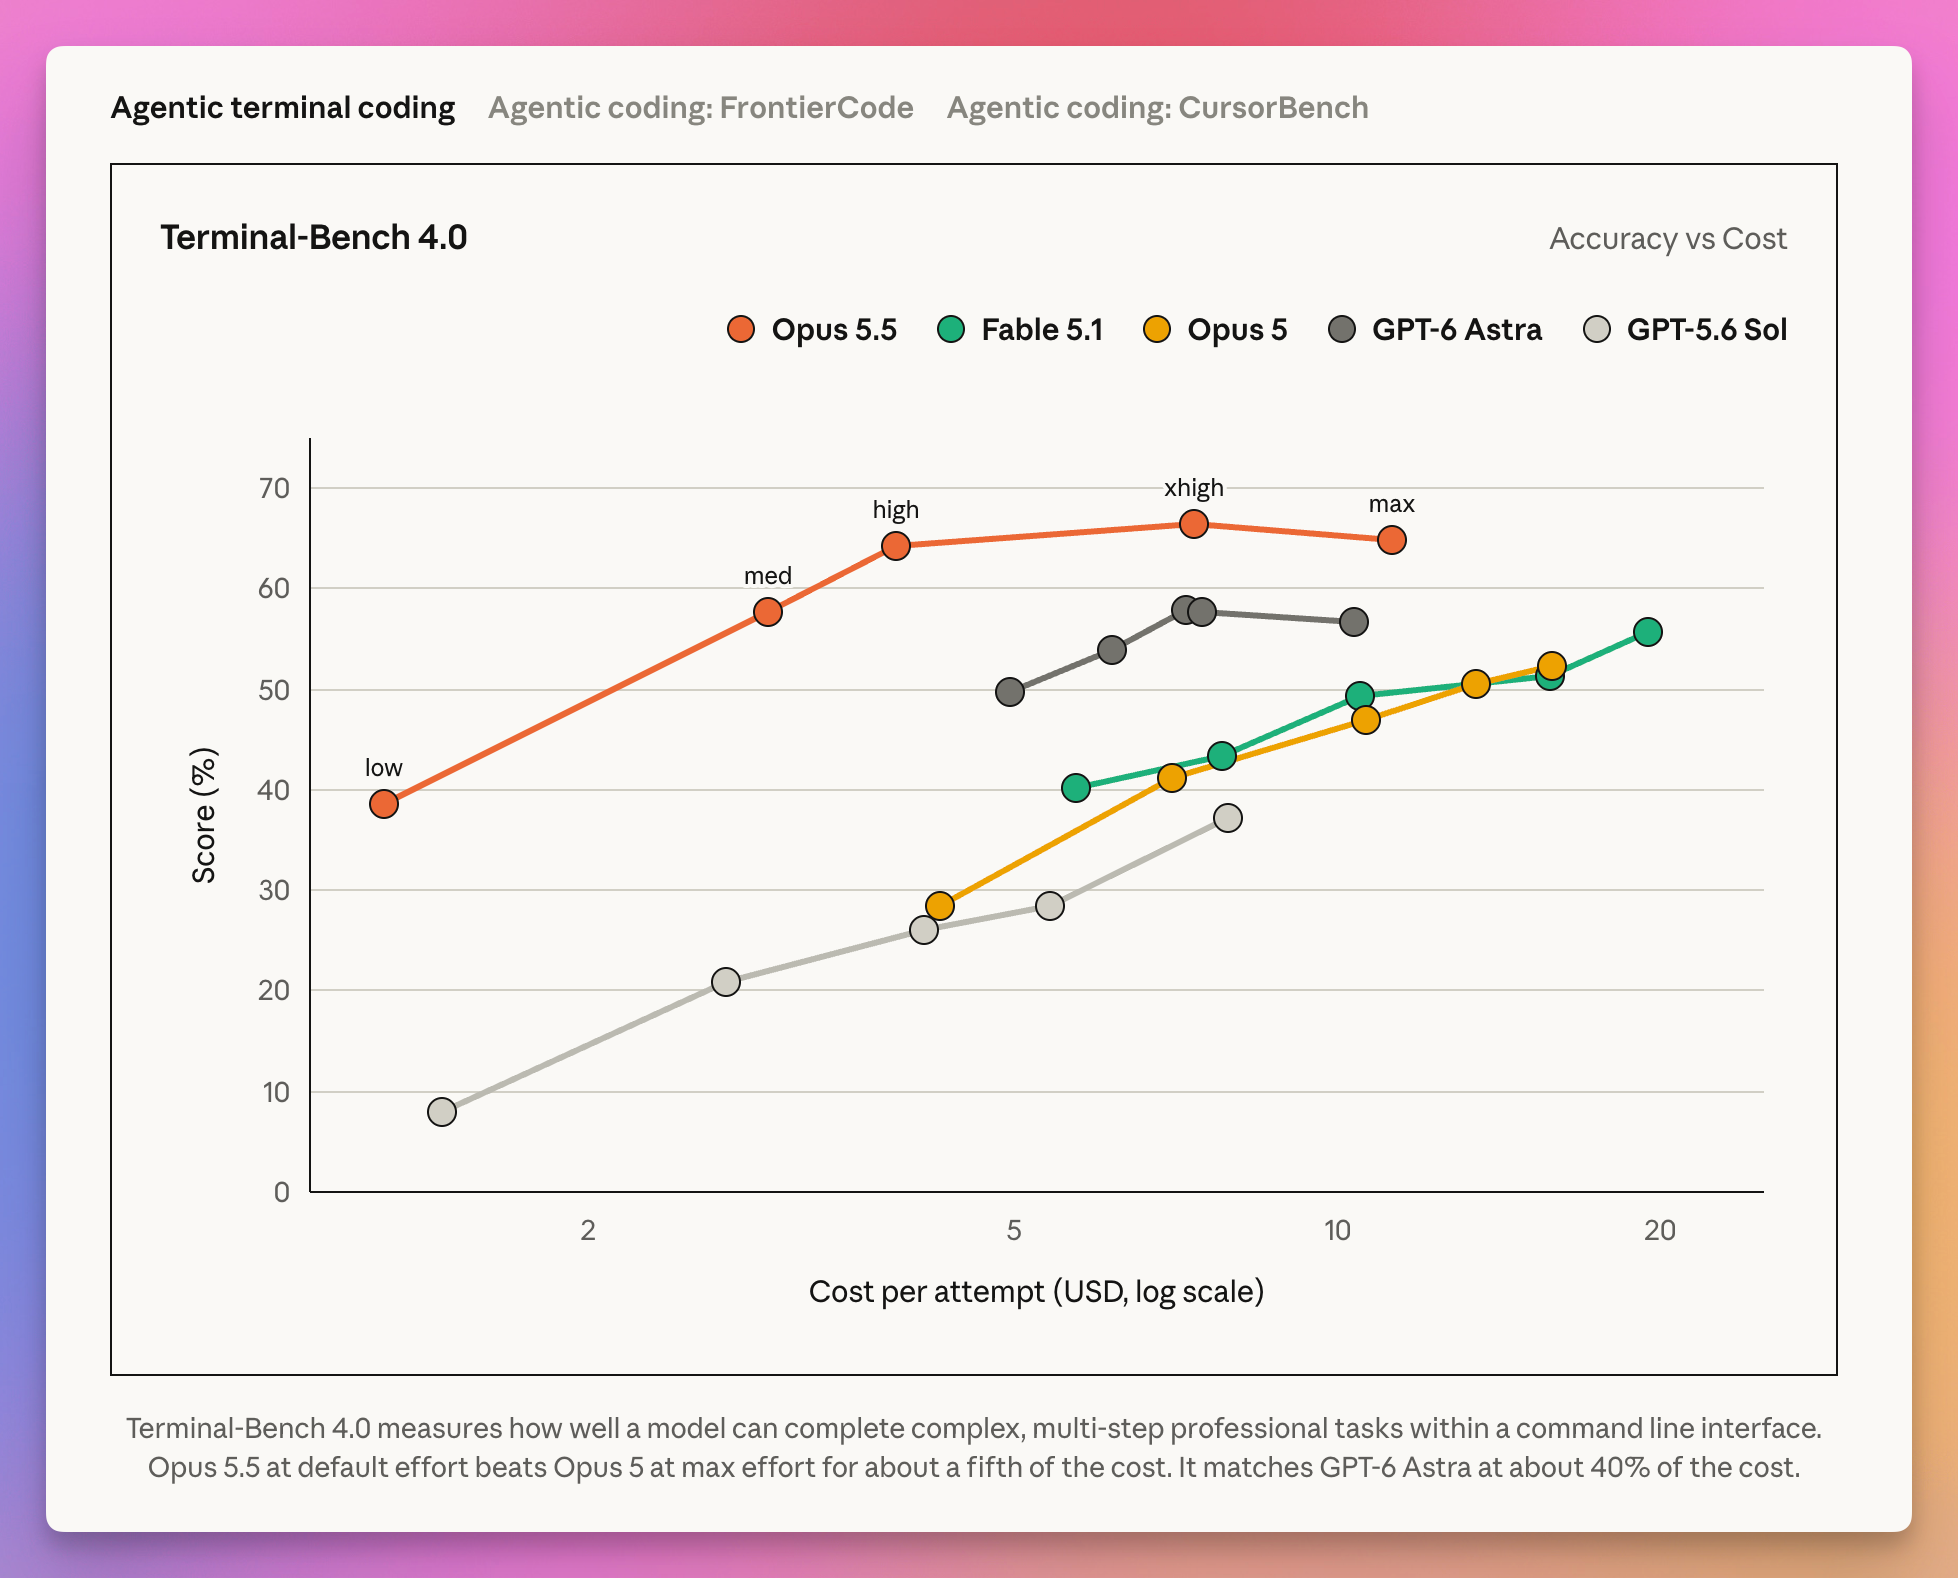
在這組命令列工作測試中,Opus 5.5 的得分到了 xhigh 已接近高點,再開到 max,花費增加,分數卻沒有提高。橫軸是每次任務的美元成本(對數刻度),縱軸是得分。圖片來源:Anthropic,Terminal-Bench 4.0,點圖可放大。
圖上那一點下降仍可能是測試波動;官方列出的 Opus 5.5 標準誤為 ±2.6 個百分點。這裡值得看的是,多花的成本已經沒有換到明顯的進步。
與其把一個對話開成愛因斯坦,我更想讓好幾個普通人併行做事
一件工作可能要跑很久,但裡面每一步有多難,是另一回事。如果手上有幾件範圍清楚、也準備好的工作,我更想讓它們分頭進行。推理強度可以根據模型先用 medium;需要時再往上提升到 high。
比如,手上有五張能分開做的工作卡,就各開一個對話來做。比起臨時亂找一個題目,把 Extra High 和 fast 都開下去硬燒,我更想把這幾件本來就打算做的事做完。重點是這些工作要能「分開做」。多個 session(對話)同時跑,要怎麼分工、有哪些設定要先處理,我在三個 Codex task 一起做網站那篇有寫。
每張卡片至少要交代三件事:
- 這次要完成什麼。
- 可以改哪些檔案或內容。
- 我最後要看什麼,才知道它做完了。
這些卡片可以在平常慢慢存。碰到一件想做、今天卻沒空的事,就先記下來,順手補上要改哪裡、怎樣算完成。
等 Tibo 又說要 Reset,就從裡面挑幾件能分開做的。要開幾條,也看自己有沒有時間把結果逐一看完。
下次聽到「快要 Reset 了」,我希望打開待辦,就有幾件早就想做的事可以交出去。
額度怎麼一路用到見底,我寫在 Pro 20× 那篇(尚未公開);待辦有了,卻還是不知道下一件該交給誰,則是額度顧問那篇(尚未公開)處理的問題。